
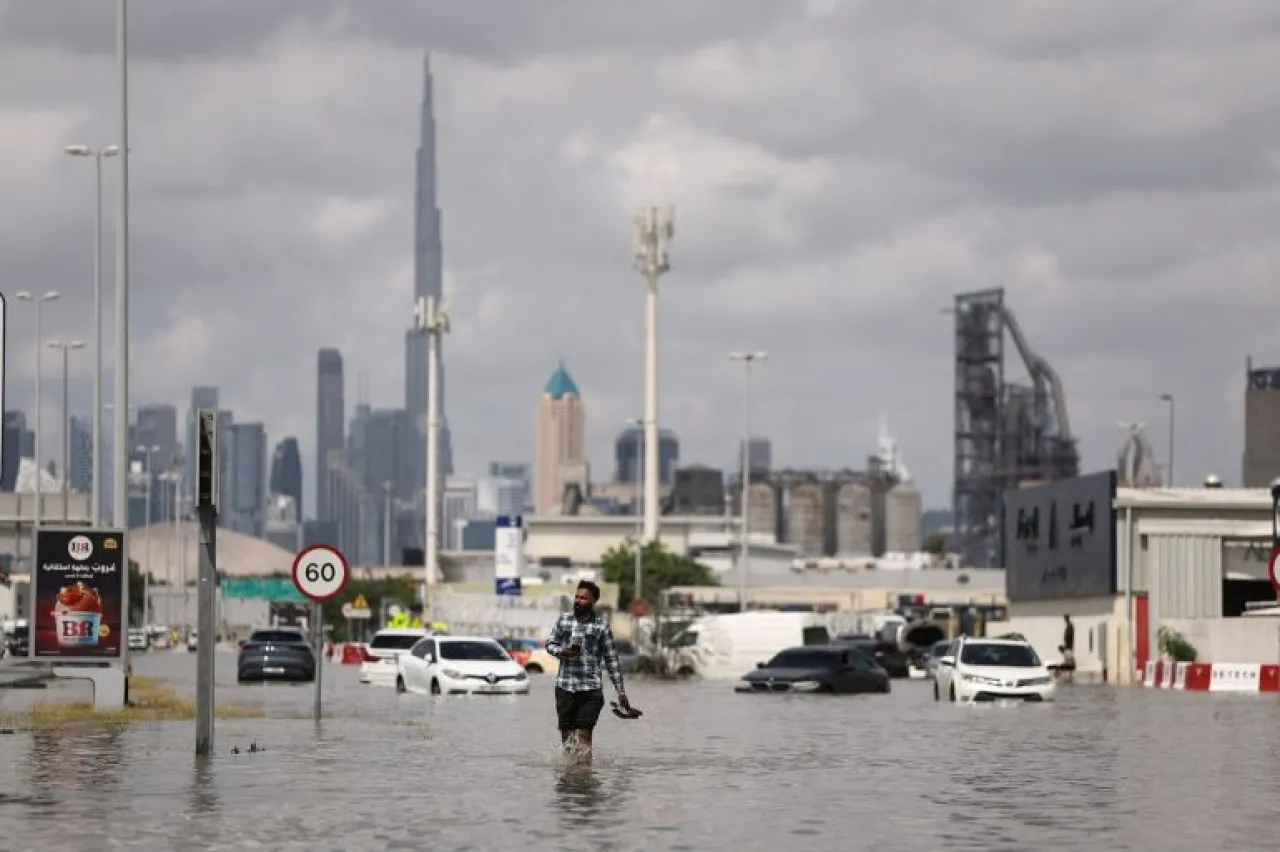
خبرني - قبل أن تغمر الأمطار الغزيرة شوارع مدينة دبي في أبريل/نيسان 2024، وتعطل الحركة وتلحق أضرارا واسعة بالبنية التحتية، كانت بعض نماذج الذكاء الاصطناعي قد التقطت بالفعل إشارات إلى الحدث غير المسبوق قبل وقوعه بأيام، رغم أنها لم تلحظ خلال تدريبها أمطارا بهذه القوة في المنطقة نفسها.
وجدت دراسة جديدة نشرت يوم 7 أكتوبر/تشرين الأول في مجلة "ساينس أدفانسز" أن نموذجي الطقس القائمين على الذكاء الاصطناعي "غراف كاست" و"أيفس" (AIFS) تمكنا من توقع توقيت ومكان وشدة أمطار دبي الاستثنائية بدقة لافتة قبل وقوعها بما يصل إلى 8 أيام، بينما نجح نموذج ثالث هو "فوكسي" في توقع الحدث نفسه، لكنه قلل بصورة واضحة من كمية الأمطار المتوقعة.
اختبار ناجح
ويقول تشيانغ صن، الباحث في كلية علوم الغلاف الجوي بجامعة نانجينغ والمؤلف الرئيسي للدراسة، إن أمطار دبي كانت خارج نطاق ما اعتادت النماذج رؤيته محليا أثناء التدريب، وهو ما يجعل الحدث اختبارا صعبا لقدرة الذكاء الاصطناعي على التعامل مع طقس نادر وغير مسبوق في منطقة بعينها.
وقد بدأت العاصفة الشديدة منتصف أبريل/نيسان 2024، وسجلت بيانات مشروع إعادة التحليل الخاص بالمركز الأوروبي للتنبؤات الجوية المتوسطة المدى، التي استخدمها الباحثون، نحو 60 مليمترا خلال 12 ساعة عند حساب المتوسط على مساحة تبلغ 100 كيلومتر في 100 كيلومتر حول دبي، وهو ما يقارب ضعف أعلى كمية أمطار ظهرت في بيانات التدريب الخاصة بالمنطقة، والتي لم تتجاوز 33 مليمترا خلال الفترة نفسها.
ويضيف تشيانغ في تصريحات للجزيرة نت "في بعض المواقع القريبة من دبي، تجاوزت الأمطار 100 مليمتر خلال 12 ساعة، وهي كمية تفوق متوسط ما تتلقاه المدينة عادة خلال عام كامل، بينما قدر الفريق أن حدثا بهذه الندرة له فترة عودة وسطية تقارب 154 عاما، مع قدر كبير من عدم اليقين الإحصائي بسبب ندرة مثل هذه الأحداث".
وأدت العاصفة إلى فيضانات واسعة وأضرار في البنية التحتية، بينما تشير الدراسة إلى خسائر تأمينية قدرت بنحو 3 مليارات دولار أمريكي وسقوط 5 وفيات، و"هو ما يوضح أهمية امتلاك تحذيرات مبكرة موثوقة عندما تواجه المدن الجافة أحداثا مطرية لم تصمم بنيتها التحتية عادة لاستيعابها" حسب المؤلف الرئيسي للدراسة.
وما فوجئ به الباحثون ليس قدرة النموذجين على التنبؤ بالعاصفة وحدها، وإنما الطريقة التي يبدو أنهما استخدماها للوصول إلى هذه النتيجة، إذ وجد الفريق أن الذكاء الاصطناعي لم يتعلم على الأرجح من أمطار دبي الأضعف ثم يتخيل ببساطة حدثا أقوى منها.
إذ تشير التجارب إلى أن النماذج استفادت من أحداث مطرية شديدة ذات ظروف جوية مشابهة حدثت في مناطق أخرى من نصف الكرة الشمالي، ثم نقلت ما تعلمته من تلك الحالات إلى دبي، وهي آلية يطلق عليها الباحثون اسم "الانتقال المكاني".
شكوك حول قدرات الذكاء الاصطناعي
وللتأكد من ذلك، عدل الباحثون بيانات تدريب نموذج "غراف كاست" بحيث خفضوا شدة الأمطار في الأحداث المشابهة التي وقعت خارج دبي، من دون تغيير البيانات التاريخية الخاصة بدبي نفسها، ثم أعادوا اختبار النموذج على عاصفة 2024.
وعندما حرم النموذج من الأمثلة القوية القادمة من مناطق أخرى، انخفض توقعه لأمطار دبي إلى ما يزيد قليلا على 30 مليمترا خلال 12 ساعة، رغم أنه ظل قادرا على توقع حركة النظام الجوي العامة بصورة صحيحة، وهو ما قدم دليلا قويا على أن نجاحه الأصلي اعتمد على التعلم من أحداث بعيدة لكنها متشابهة مناخيا.
ويرى تشيانغ أن هذه القدرة قد تكون مهمة خصوصا للمناطق التي تمتلك سجلات مناخية محدودة، لأن النموذج يستطيع نظريا الاستفادة من أحداث مشابهة وقعت في أماكن أخرى، وهو ما قد يفتح الباب أمام تحسين التنبؤات في مناطق مثل أفريقيا التي تعاني نقصا نسبيا في أرصاد الأمطار التاريخية.
ويشدد الباحث على أن النتائج لا تعني أن الذكاء الاصطناعي أصبح قادرا على توقع أي حدث متطرف لم يحدث من قبل، لأن الدراسة وجدت أن "غراف كاست" و"فوكسي" ما زالا يواجهان صعوبة في تمثيل أقصى كميات الأمطار، حتى عندما تكون أحداث مشابهة موجودة داخل بيانات التدريب العالمية.
ويفسر الباحثون جزءا من المشكلة بأن نماذج الذكاء الاصطناعي تميل إلى التقاط الأنماط الجوية الكبيرة بسهولة أكبر من التفاصيل الصغيرة والحادة التي تتحكم أحيانا في شدة الأمطار القصوى، وهو ما يؤدي إلى تنعيم التوقعات وتقليل القمم المطرية، خصوصا كلما طال زمن التنبؤ.
كما تواجه الدراسة مشكلات أخرى، إذ استخدمت بيانات مشروع إعادة التحليل، الخاص بالمركز الأوروبي للتنبؤات الجوية المتوسطة المدى، مرجعا أساسيا، رغم أن الباحثين يقرون بأنها قد لا تمثل أعلى كميات الأمطار المرصودة بدقة كاملة، كما لم تقارن الدراسة بصورة مباشرة أداء نماذج الذكاء الاصطناعي بالنماذج التقليدية المعتمدة على الفيزياء، رغم الإشارة إلى أن نموذج المركز الأوروبي توقع الحدث أيضا بدقة جيدة.
كذلك أجريت تجربة تعديل بيانات التدريب بصورة كاملة على "غراف كاست" فقط بسبب القيود التقنية والحسابية، بينما اقتصر تحليل "أيفس" على اختبارات محددة، ولم يتمكن الفريق من إجراء بعض التحليلات نفسها على "فوكسي" ولذلك تحتاج النتائج إلى اختبار أوسع على نماذج وأحداث متطرفة أخرى.